ai带货视频软件哪个好用凭什么判断?AI摊开六个可比点
六个可比点摊开,把模糊印象换成能一条条对照的东西。
「ai带货视频软件哪个好用」被问出来的时候,问的人多半已经看过几处介绍,却仍旧不知道该拿什么去比。问题不在信息太少,而在参照系没搭起来——没有一套共同的比法,每一家的说法听起来都成立,凑在一起却互相打架。
比较这件事有个被普遍跳过的前置动作:先把自己的需求排序。这一段一省,后面的比对就会变成「哪个听起来更全」,而不是「哪个对得上我这一批活」。排序花不了几分钟,却决定后面六项到底按什么权重看。
这篇把六个可比点摊开,逐条给出能拿去打分的判据,再对应到青虎AI 这条线上可查的事实,最后按几种典型场景走一遍比对。全程不给名次,因为名次只在条件一致时才成立,而条件是你自己排出来的。
比较之前先把需求排序,这一步最常被跳过
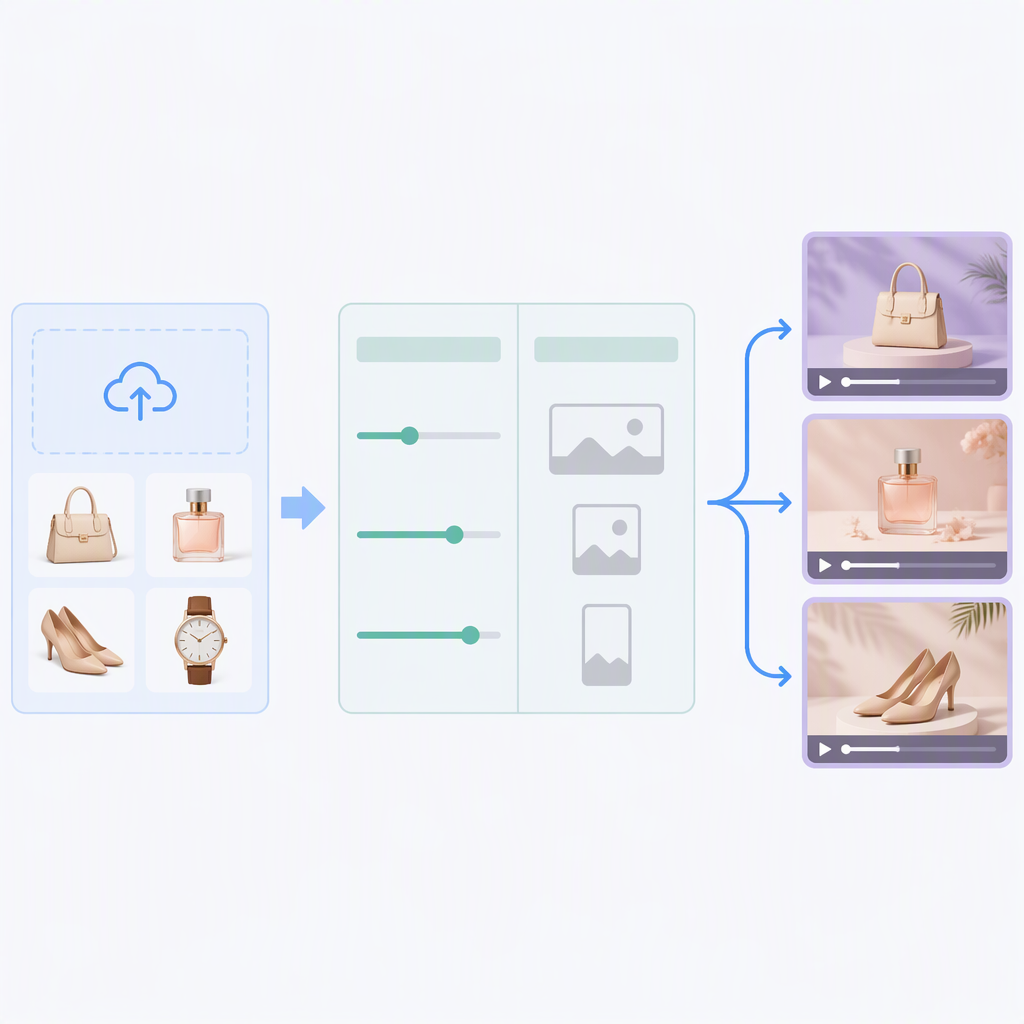
排序的动作很简单:把你最在意的那两条列出来,其余四条顺次排下去。比如「批量最大的那一批货要多久出齐」排第一,「多平台位置一次能不能交」排第二,那么下面六个维度里,批量能力与平台适配就该占更重的分量。
之所以要先排,是因为六个维度之间常有冲突。能力覆盖面广的,操作门槛往往不低;门槛低的,批量上限有时会紧一些。没有排序,遇到冲突就只能在两处之间凭感觉选;有了排序,冲突处该往哪边倒,答案是现成的。
还有一个顺带的好处:排序把「谁更好」这个没法回答的问题,换成了「按我这套权重谁更贴」。前者要一个绝对答案,后者要的是一个对照结果——对照结果你自己就能算,不必等谁来下结论。
权重不是给工具打的,是给你自己打的。同一个维度,落在测款的人身上权重很低,落在批量上新的人身上权重很高。排序之所以不能照抄别人的,就是因为这套权重只反映你这批活的形状。
排序这件事还有个具体做法值得说清:不要凭印象排,用一句「如果只能保住一项,我保哪一项」来问自己。问三遍,前三名的次序就排出来了。剩下三项不必分先后,它们在你这一批活里的作用大致相当。这里说的每一项,指的都是一件工具该被问到的那一面,不是某一件工具本身的名字。
排完之后还要做一次交叉检查:把你排在最前的那一项,反过来问一句「如果这一项它表现很差,我还能忍吗」。答案是「忍不了」,说明这一项的权重排对了;答案是「也能凑合」,说明它该往后挪。这一步能挡掉不少凭直觉排出来的伪权重。
还有一处提醒:权重会随经营阶段变。刚开始只有一两个链接的时候,最快那一条往往排在前面;等到上新变成日常,能不能成批走就顶了上来。同一张表,过几个月再排一次,次序很可能不一样——这不是表有问题,是你手上的活变了。阶段一变就重排一次,比重排之后一直照着用更省事——表是活的,跟着活的形状走,才不至于拿旧一轮的权重去评这一轮的货。
给权重加一行「过多久重排一次」。测款阶段可能每一轮都要重排,批量上新的阶段可以几轮才重排一次。把重排的周期也写进表里,这张表才不会变成一份过期文件。
可比点一:能力覆盖面,看它接的是从素材到成片的哪一段
第一条维度问的是「这段活它碰不碰」。判据可以写成三个问题:出画面这一段它管吗、脚本与声音这一段它管吗、后期那几层它管吗。三个问题里答「管」的越多,覆盖面越宽,一条链要走的地方就越少。
宽不代表更合适,这一点要先说清。覆盖面宽的做法往往在每个点上只做到一个够用的程度;窄的做法可能在某一处做得更深。要不要走宽的那一条,取决于你这批活是「每样都要沾一点」还是「只在一处要求高」。
拿这条线对照,青虎AI 的覆盖面可以从几处入口看出来:商品广告一键成片这一段接的是「从图到内容」这一步,自动完成镜头编排、画面衔接、配音匹配、字幕生成;分镜生成器那一段往上接了一格,商品图先进脚本、再出分镜图、再基于分镜素材出完整内容;素材后期那几处又各接一层,去字幕、去水印、画质提升、修改封面各管一处。
用三个问题打分。出画面这一段管不管、脚本与声音这一段管不管、后期那几层管不管。答「管」记一档,答「不管」空着。三档全空说明它根本没碰到你的活,后面的维度不必再比。
覆盖面这一条还有一处容易被算错:把「同一个界面里能点到」当成「同一段活里收得住」。能点到只是入口多,收得住才是链路短。判断的办法是数一数从素材到成品要在几处之间来回——来回次数才是覆盖面真正的量尺。
可比点二与三:分镜与成片的输出形态、剪辑门槛
第二条问的是「出来的是什么形状」。判据写成具体名词:一条竖版内容、一套换比例的版本、一叠能直接投放的素材,还是只有一段画面要自己再接。形态答得越具体,后面才越不会拿一个错误的期待去评结果。
这一线的输出物形态有几处可以对照着看:一键成片这一项出来的是成品内容,最长 60 秒,默认竖屏 9:16,可切 16:9 与 3:4;广告视频素材那一段出来的是适配投放的素材,自定义时长在 15 秒内,多比例可切;分镜生成器那一段中间还会多出一个产出物——分镜图本身。
第三条问的是「要不要先学」。判据是三个动作:装不装专业软件、懂不懂写提示词、能不能在同一个地方改完。三个动作都不需要的,门槛最低;有一项需要,就得把学习成本算进第一周的时间账里。
这一线的门槛可以从动作的写法上读出来:剪辑这一段写明是 AI 辅助、零门槛,处理裁剪、拼接、转场这类基础操作;提示词润色那一段则是把粗略描述优化成专业级提示词,等于把「会不会写提示词」这一项从门槛里拿掉了。
| 维度 | 能拿去打分的判据 | 这条线上的可核口径 |
|---|---|---|
| 输出物形态 | 出来的是单条成品、多比例版本,还是半成品 | 一键成片出成品,最长 60 秒;广告素材出投放用素材,15 秒内可自定义时长 |
| 操作门槛 | 要不要装专业软件、要不要懂提示词、能不能同处改完 | 剪辑这一段零门槛,处理裁剪、拼接、转场;提示词润色把粗略描述写成专业级指令 |
两条并排看会读出一件事:形态与门槛常常成对出现。形态越完整,门槛往往越高,因为完整意味着中间要替你做的决定更多。看清楚这一对关系,就不会拿「出得越全越好」当唯一标准——你要的是这一批活能直接用上的那一档形态。
可比点四:批量能力,看一轮能带多少素材
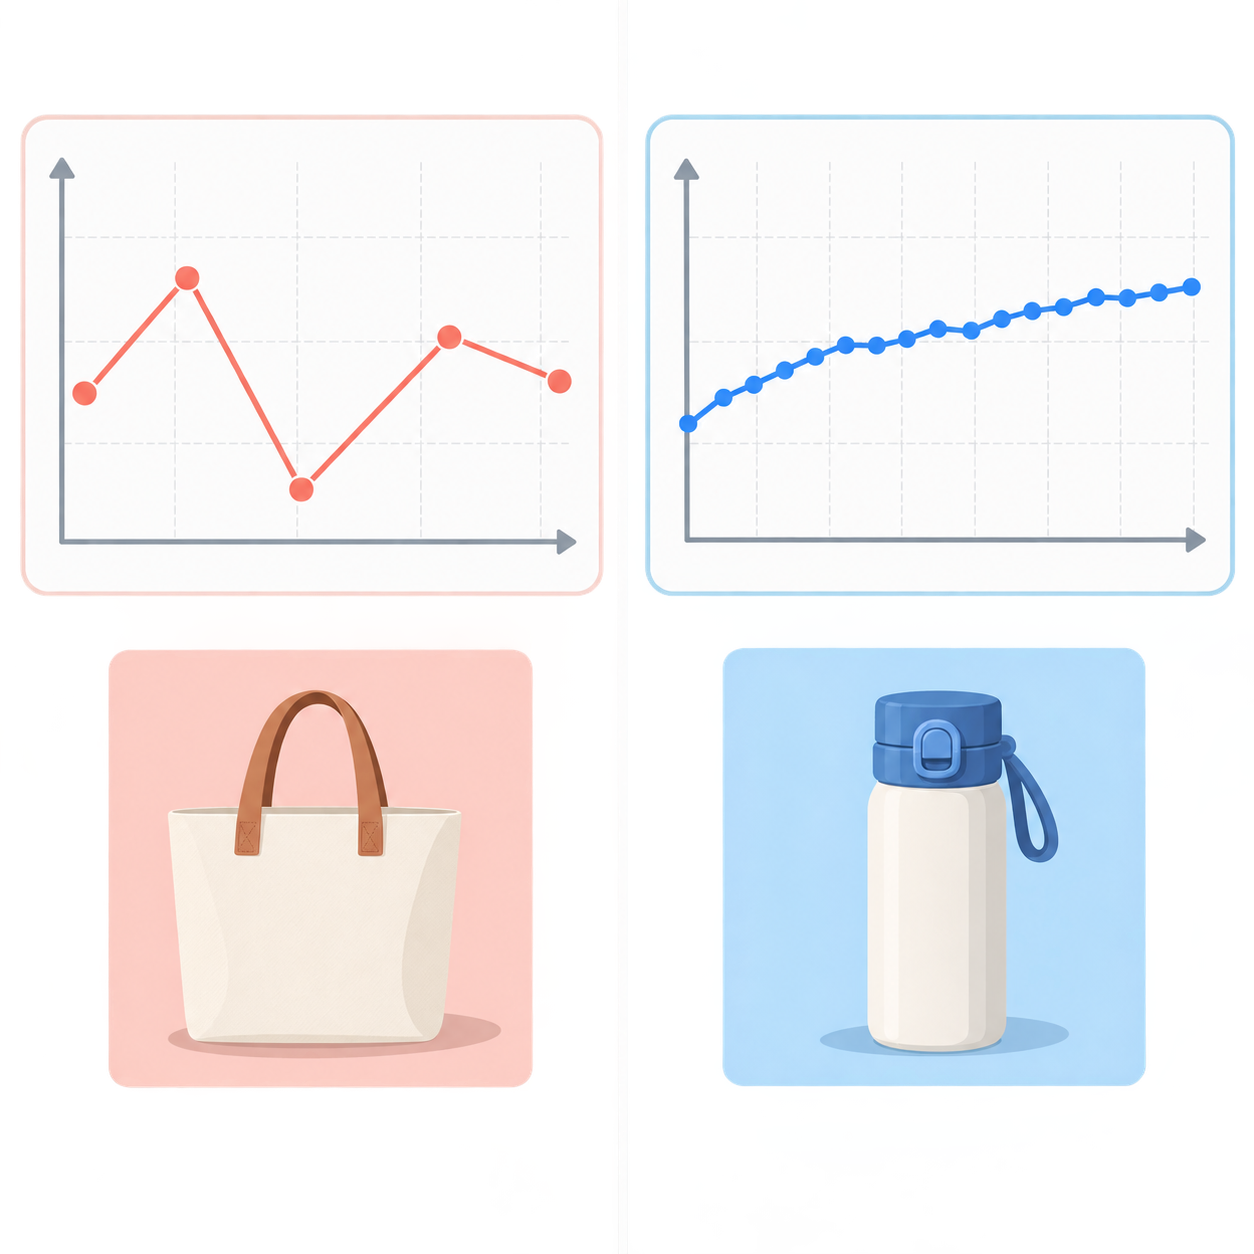
第四条问的是「一轮能上多少」。判据分两半:单次的上限写在哪儿,超过之后怎么处理。上限这个数是可以逐条核的,处理方式则决定了你几轮走完。
这一线的上限写得比较直白:商品广告一键成片这一项,输入是 1-7 张商品图或模特图。这个数决定了一轮能喂进去的体量,也决定了这批货要分成几轮。把总量除一下,轮次就出来了——这一步花一分钟,能省掉后面安排节奏时的猜测。
超过之后怎么处理的判据是:能不能分批而不影响统一度。分批本身不是问题,问题是每批之间的口径会不会跑偏。分批的依据通常从按类目、按款式、按面向的位置三种里挑一种,关键是批内够近、批间能分开。
用一道除法自测批量。这批货一共多少件、每件准备几张图、单项上限是几张——三个数一除,轮次就出来了。算出来的轮次乘上每轮的人工时间,才是这一批货真正占用的时长。
批量能力还有一处常被忽略的分项:每轮之间要不要重定口径。如果每一轮都得重新写一遍条件,批量就变成了「很多次单件」;如果口径能跨轮沿用,批量才真的省时间。判据是条件能不能被记下来照着填,这跟做法无关,跟你的习惯有关。
可比点五与六:平台适配、数据留存
第五条问的是「一次能不能出多种尺寸」。判据是比例是内置的还是自己算,切位置要不要重做。内置的比例意味着你不必自己去量尺寸,切位置时改一个选项就行。
这一线上的比例是内置的:一键成片默认竖屏 9:16,可切 16:9 与 3:4;广告素材那一段同样支持多比例切换。语种这一层另有一处刻度可核:视频翻译这一段覆盖英语、日语、韩语、法语等 13 种主流语种,做语音翻译、字幕翻译与面容口型适配。多位置交汇的场景,判断的是这套能覆盖到几种,而不是逐个位置去试。
第六条问的是「跑完留下的在哪儿」。判据拆成三问:原始素材动不动、成品存不存、当时用过的条件记不记。三问里的第三问最容易被漏,可它恰恰决定下一轮有没有起点。
这一线在留存上有一处可以核:青虎AI 这一类处理递出来的是新内容,不覆盖原始素材,所以试错便宜。数据这一侧另有一处刻度:短视频数据引擎把采集内容按视频、平台、时间等维度整理成表导出,并可对竞品达人做分组监测与对比分析;原始依据里同时写着边界,采集数据用于运营分析和商业决策是合规的,分析结果仅供参考,具体创作方向还要结合自身品牌调性。
| 维度 | 能拿去打分的判据 | 这条线上的可核口径 |
|---|---|---|
| 平台适配 | 比例是内置还是自己算;语种覆盖到几档 | 默认 9:16,另可切 16:9 与 3:4 两种横向画幅;翻译覆盖 13 种主流语种并做面容口型适配 |
| 数据留存 | 原素材动不动、成品存不存、条件记不记 | 递出来的是新内容,不覆盖原素材;数据侧导出的是按多维整理的采集表,结果仅供参考 |
两条放在一起,会照见一个共同的判断法:这两条问的都不是「有没有」,而是「留下的是不是能再用一次」。适配留下的是比例与语种的覆盖清单,留存留下的是条件与成品的位置。凡是回答不了「下一次怎么用上」的,都在这一条上打了折扣。
拿这两条自测复用性。把你上一轮用过的做法翻出来问两句:比例与语言那一套现在还能不能直接照用、上一轮的条件还找不找得到。两句都答「能」说明留存这一条过关;有一句答不上,先补归档的动作。
这两条还共同指向一处容易被忽略的事实:真正的复用发生在「下一轮开工时不用重想」这一刻。比例清单能照用,条件记录能翻到,下一轮就少一段摸索;每一样都要从头问一遍,哪怕能力再全,复用也只是一句空话。
写到这里可以给六个维度各配一个动作口诀,方便记:覆盖面问「碰到哪一段」,形态问「出来是什么」,门槛问「要不要先学」,批量问「一轮几张」,适配问「几档比例几种语言」,留存问「留下的还能不能用」。六句口诀背下来,比记六个名词管用。
比的次序:什么时候可以停下不再往下比
六个维度不是每一轮都要比完。比到某一步发现对不上,就该停下,硬把六项走完只是在给一个已经出局的候选补理由。停下的位置由你的权重排序决定,不由六项的排列顺序决定。
第一道闸
先过覆盖面
它接的如果不是你要的那一段,后面五项不必再比。这一段判断最快,也最容易被跳过——很多人是先比其余几项,比到最后才发现第一格就不对。
第二道闸
再过形态与门槛
形态答得上「出来就是我直接能用的那一种」,门槛答得上「当天能上手」,这两项都过的,基本可以往下走。有一项不过,先看它在你的权重里排第几,排得靠前就停。
第三道闸
最后过批量、适配与留存
这三项偏定量,能落成数字与清单。落到数字之后,谁的分数高一目了然,不必再争。到这一步还没被筛掉的,才值得带着你去核当期信息。
卡在哪一闸,停在哪一闸。被第一道闸筛掉的东西,不值得为它补后面五项的理由。省下的时间留给真正能走到最后的那几个。
过闸的标准自己定。「当天能上手」这类标准看着含糊,写下来就清楚了:指的是不必先学一个新软件,也不必先背一套提示词写法。
三道闸的顺序还有一处讲究:越靠前的闸越省时间,越靠后的闸越费时间。把覆盖面排在第一位,不是为了它最重要,而是为了它最便宜——一句话就能问出来的东西,犯不着放到最后。
比的目的是筛,不是排。排出一二三名没有用处,因为名次只在条件一致时成立。筛出「能对上我这批活的那几个」才是有用的结果,剩下那几个值得你带着判据去核当期信息。
信息边界:哪些能核,哪些只能去官方页面看
六个维度比完,有一句话必须放在这里。本文只交代这条线通用的判断维度与青虎AI 一侧可逐条核的口径;至于别家做法在当前版本里的具体呈现,不在本文的把握之内。本文不逐一罗列第三方工具的规格、界面细节与版本信息,具体以该工具官方页面为准。
这条边界不是客套。通用维度是行业里公开的框架,谁都能拿去用;具体到某一件事的界面、按钮、参数、版本,属于会随时间变动的信息,只有官方页面上的当期刊载才算数。把两类信息分开,比把两者混着读要安全得多。
边界立起来之后,比较的动作反而更清楚了:六个维度你自己能排、自己能打分,这部分不依赖任何外部说法;剩下那一小部分需要去核的,带着你自己写好的六行判据去官方页面逐条对,得到的才是能拿来做决定的当期信息。
把问题分成两栏带去核。左栏写六个维度各一句判据,右栏写你能自己答出来的部分。带着这张纸去看任何一处说法,你核的是条件对不对得上,而不是对方讲得动不动听。
四种场景走一遍比对
六项判据摆好之后,落到具体情形上才看得出怎么用。下面四类场景覆盖了常见情形,每一类给出该看重哪两项。
场景一:单店测款,一轮只要一条。
这一类最该看输出物形态与操作门槛。量少,批量能力与平台适配的权重可以放低;重点是把一条做出来看清楚,所以形态要贴用途、门槛要低到当天能上手。跑完把两版并排比,把能对上的那一版留成标准。
场景二:多 SKU 上新,一批几十件。
这一类最该看批量能力与能力覆盖面。单次上限与分批依据决定轮次,覆盖面决定一轮里要不要换地方。先把素材按共同特征分叠,再按上限算轮次,两件都做完,节奏才排得出来。
场景三:跨境多语种,一条内容要交好几个位置。
这一类最该看平台适配与输出物形态。比例要不要重做、语种覆盖到几档、出来的东西能不能直接按位置交出去——三项问完,多位置的活就有了准绳。语言层单独提出来先做,画面层再谈微调。
场景四:只想先试一条,看看值不值得往下走。
这一类最该看操作门槛与数据留存。门槛决定试的成本,留存决定这一条试完之后能留下什么。门槛低、条件能记下来,试一条这件事才不白试——它留下的不只是成品,还有一份能拿去跑批量的口径。
四类场景摆在一起,能看出同一件事:同样六个维度,不同场景里的权重完全不同。测款的人把批量能力排前面,等于给自己加了一道不必要的门槛;批量上新的人把门槛排前面,等于忽略了自己最需要的那一项。权重按场景排,比按直觉排准得多。
四类之外还有一种常见情形:这一轮里同时压着两种活。比如一边要给新链接做测款,一边要给老品补一批素材。这时候别用一张权重表硬套两种活,分成两张表各排一次,反而更省事——两种活的最贵那一格本来就不在一处,硬塞进一张表里只会互相打架。
一轮一张表。这一轮的主线是测款就按测款排,是上新就按上新排。主线认清楚,六个维度里该重的自然就重了;主线没认清楚,同一张表上每个维度都像很重要。
选型最容易看错的四个地方
六个维度比完,回头看看错的地方,偏差多半出在把某一项当成全部。下面四处都能让人在几分钟内生出「我懂了」的错觉。
看错之一:把能力覆盖面当成越多越好。
覆盖面宽意味着每个点上大概只做到够用。你的活要是在某一处要求高,宽反而分散。正确的问法不是「它管几段」,而是「我要的那一段它管到什么程度」。
看错之二:把输出物形态当成越全越好。
出得越全,中间替你做掉的判断越多,你要交代的条件也越细。形态该按用途选:这一批活要的是能直接交出去的一条,多出来的那几种形态对你是负担而不是加分。
看错之三:把单次上限当成越大越省事。
上限大意味着单轮装得多,但不代表一轮就该装满。装满一轮的前提是这批素材彼此够近;素材差得远的硬凑在一轮里,出来的东西会在同批之内分裂成几种样子,省下的轮次全都赔回去了。
看错之四:把「能出内容」当成「能出我要的那一条」。
出内容这件事门槛并不高,难的是出你要的那一条。分野不在本事大小,而在你报出的条件够不够细:素材几张、画幅按哪个位置、话语从哪儿来。条件含糊的时候,再成熟的打法也只能递来一条平平的东西。
四处偏差底下是同一个动作:跳过「先给自己的需求排序」,直接跳进六个维度里逐项比。跳过它当下确实省事,却把判断的代价挪到了后面——等察觉不对劲时,时间、素材和一轮的活都已经投进去了。
另有一处更隐蔽的偏差值得一并提:把这一类的通用维度与某一家页面上写的说法混成一件。前一类能当方法用,后一类是会随版本变动的说法,只适合现下去官方页面核,不宜长期照着办。
六维之外的三条前提:不在这六项里,却决定比得对不对
六个维度覆盖的是「怎么比」,还有三件事不在这六项里,却决定了这场比较能不能成立。它们常被当成常识跳过,而跳过之后的比较,往往比到最后也不知道自己在比什么。
第一条前提是这批活的规模。同样一套判据落在一条内容和落在几十条内容上,读出来的重点完全不同。规模先估出来,六个维度才有落点;规模含糊的时候,覆盖面与批量这两项的分数会在不同轮次里来回摆。
第二条前提是你手上现有的素材形态。素材是同一套光拍出来的,还是各处攒来的,直接决定第二格要花多少时间。这一条不影响某一项能力的高低,但会改变六个维度之间的真实权重——素材越杂,归堆与批量的分量就越重。
第三条前提是交付的时间底线。这一轮什么时候必须交出去,决定你能不能先跑一小批验证,还是只能按最稳的那一版一次走完。同一套判据配上紧的时间线,能接受的做法会立刻收窄;配上宽松的时间线,值得试的路径就多了起来。
| 前提 | 它改变的是哪一项 | 怎么先估出来 |
|---|---|---|
| 这批活的规模 | 覆盖面与批量的相对权重 | 数一数要出几条,一条还是几十条 |
| 现有素材的形态 | 归堆与分批要花的时间 | 翻一遍手上的图,看是同一套光还是各处攒的 |
| 交付的时间底线 | 能不能先验证再铺开 | 写下这一轮最晚什么时候交 |
拿一件工具来做比对的顺序也值得顺一句:先把三条前提写下来,再从这件工具身上问六个维度。前提写在前面,六个维度的答案才有参照;前提没写,六项答得再细也只是六段孤立的话。
三条前提都是你自己就能答出来的,不必去翻任何页面。也正因为如此,它们最容易被跳过——太容易得到的东西,往往被当成不必写下来的东西。写下来这一步花不了两分钟,却能省掉后面一整轮的来回。
顺带说一处:这三条前提都不是一次性答案。规模会变、素材形态会变、交期会变,所以每一轮开工前都该重新估一次。把它们当成表格最上面那三行,比记在脑子里可靠得多。
把六项判据抄成一张自查表
六个维度都摊开之后,还有最后一件事:把它们收成一张你自己带得走的表。表不用复杂,六行就够,每行三格——维度名、你写下的判据、你打算怎么填。
第一行到第三行分别是能力覆盖面、输出物形态、操作门槛。这三行偏「定性」,填的时候写成短句即可:它接哪一段、出来是什么、要不要先学。第四行到第六行是批量能力、平台适配、数据留存。这三行偏「定量」,填的时候尽量落成数字或清单:一轮几张、比例有几档、条件记在哪儿。
填完之后再看一遍,把这个表按你前面排的权重重新排一次。权重高的行挪到上面,权重低的往下沉。排完之后从上往下读,读到这里就够了——你没有在挑名字,你在核条件,这就是这一整套动作的全部意义。
剩下那一部分是人工的活。品牌基调、合规说法、最终哪一条用出去、什么时候发,这几件的答案只长在你自己的商品与客人身上。青虎AI 在这条线上交到你手里的东西,始终停在素材与初稿这一层。判断哪一张能用,仍要人来定。
常见问题:十三个疑问逐个答
Q1:为什么要先排序,直接六项都比不行吗?
六项之间常有冲突,覆盖面广的门槛往往不低,门槛低的批量上限有时紧。没有排序,遇到冲突只能凭感觉选;排序排好,冲突处该往哪边倒,答案是现成的。
Q2:能力覆盖面这一条怎么打分?
三个问题:出画面这一段管不管、脚本与声音这一段管不管、后期那几层管不管。答「管」记一档。三档全空说明它根本没碰到你的活,后面的维度不必再比。
Q3:输出物形态看什么?
看出来的是不是你能直接用的那一档。这一线上,一键成片出来的是成品内容,最长 60 秒,默认 9:16、可切 16:9 与 3:4;广告素材那一段出来的是投放用素材,时长可自定义在 15 秒内。
Q4:操作门槛怎么算低?
三个动作都不需要:不装专业软件、不懂提示词、能在同一个地方改完。这一线上剪辑这一段写明零门槛,处理裁剪、拼接、转场;提示词润色把粗略描述优化成专业级指令,把「会不会写提示词」这一项也拿掉了。
Q5:批量能力只看单次上限吗?
不止。上限是一个数,这一线上是 1-7 张商品图或模特图;另一半是超过之后怎么处理——能不能分批而不影响统一度。分批的依据通常从按类目、按款式、按面向的位置三种里挑一种。
Q6:一轮到底该装几张?
按素材的共同特征定,不按上限定。上限是 1-7 张,装满一轮的前提是这批素材彼此够近;差得远的硬凑在一轮里,出来的东西会在同批内分裂成几种样子。
Q7:平台适配这一条看什么?
看比例是内置的还是自己算、切位置要不要重做。这一线上比例是内置的,默认 9:16、可切 16:9 与 3:4;语种这一层覆盖英语、日语、韩语、法语等 13 种主流语种,并做面容口型适配。
Q8:数据留存具体问哪几件?
三件:原始素材动不动、成品存不存、当时用过的条件记不记。这一线上递出来的是新内容,不覆盖原素材;成品与条件要你自己归位,数据侧另有按多维整理成表导出的采集结果可参考。
Q9:几种场景里,权重真的差那么多吗?
差得不小。测款最该看形态与门槛,批量上新最该看批量能力与覆盖面,跨境最该看适配与形态,只想先试一条最该看门槛与留存。同一张表,权重不同,读出来的结论完全不同。
Q10:第三方做法怎么比?
本文不逐一罗列第三方工具的规格、界面细节与版本信息,具体以该工具官方页面为准。你能自己做的部分是把六个维度的判据写好,带着这张表去官方页面逐条对。
Q11:六项里哪一项最容易看错?
覆盖面。它最容易被当成「越多越好」,而你的活要是在某一处要求高,宽反而分散。正确的问法是「我要的那一段它管到什么程度」,而不是「它管了几段」。
Q12:这六项排完之后还要做什么?
把权重高的行挪到上面,从上往下读一遍。读完你会发现自己在核条件,而不是在挑名字。这一步做完,剩下的就是按条件去比,比完由你决定。
Q13:哪些事六项比完也解决不了?
品牌基调、合规口径、最终用哪一条、发布节奏,这四件归人。它们跟维度无关,只长在你自己的商品与客人身上。
回到最开始那句话。搜「ai带货视频软件哪个好用」的人真正缺的不是一份名次,而是一张自己排过权重的六行表:覆盖面接哪一段、形态出哪一档、门槛要不要先学、一轮带几张、适配到几档、条件记在哪儿。六行加权重,问题会自己缩一圈。
把本篇里能核的部分归拢一下:一键成片这一段输入 1-7 张商品图或模特图、成品最长 60 秒、默认 9:16 可切 16:9 与 3:4;广告素材这一段时长可自定义在 15 秒内;剪辑这一段零门槛;视频翻译覆盖 13 种主流语种;递出来的内容不覆盖原始素材。这些都是能逐条核对的坐标,也是这张表里「能自己答」的那一半。
坐标核完,另一半也更清楚了。青虎AI 递过来的是素材与初稿,怎么挑、怎么定,仍旧归人。AI 不懂你的品牌调性,最终还得人来把关。六项判据能帮你把不适合的筛掉,筛不掉那一句「这条内容该说给谁听」——那始终是你的活。
一句话收束:搜这个词的人缺的不是名次,是一张自己排过权重的六行表——覆盖面、形态、门槛、批量、适配、留存各写一句判据,再按场景排权重;可核的口径都带着出处:输入 1-7 张、成品最长 60 秒、默认 9:16 可切 16:9 与 3:4、广告素材 15 秒内自定义时长、剪辑零门槛、翻译覆盖 13 种主流语种;落到你手里的仍是素材和初稿,挑哪一条、定哪一版,仍旧你自己拿。
相关入口
